Eiwitten, materialen en robots: de werkelijkheid antwoordt.
AI · FYSICA · ONDERZOEK
VECTOR +AIEDITIE 05
VECTOR • AI IN DE PRAKTIJK
Van hypothese naar proef
Dit nummer volgt een onderzoekscyclus. Eerst ontwerpen we een model, daarna kiezen we een meting en onderzoeken we wat die werkelijk bewijst.
3–9 • Onderzoek en proefkeuze
Strip en onderzoekslus op pagina 3–7; nieuwe hypothesequiz op pagina 8; wettenpuzzels op pagina 9.
10–15 • Kansen en structuren
Eerste quiz en feiten op pagina 10–11; proefkeuzedossier op pagina 12–13; structuuronderzoek op pagina 14.
16–21 • Nieuwe metingen
Correcties op pagina 16; nieuwe strip en cijfers op pagina 17–18; symmetrie en simulator op pagina 20–21.
22–27 • Robot en formule
Robotlus op pagina 22–23; budgetquiz en symbolische formule op pagina 24–25; weer begint op pagina 27.
28–33 • Hypothesen en kosten
Energie op pagina 28; likelihoodpuzzels en werkruimte op pagina 29–30; gedachten en meetkeuze op pagina 31–32.
34–39 • Selectie en natuurwetten
Nieuwe labelsquiz en gedachten op pagina 34–35; berekeningen op pagina 36; hybride toets op pagina 37–39.
40–46 • Populatie en werkplaats
Modeldossier op pagina 40; reproduceerbare toets en simulator op pagina 41–42; eigen dossier en bronnen op pagina 45–46.
47–50 • Antwoorden en bronnen
Bestaande uitwerkingen op pagina 47; nieuwe puzzels en gedachten op pagina 48; nieuwe quizzen op pagina 49; bronnen en vervolg op pagina 50.
VECTOR +AIEDITIE 05
STRIPVECTOR • AI IN DE PRAKTIJK
De snelste ontdekking
AXI toont een kristalmodel. De onderzoeker vraagt iets dat een mooie voorspelling niet kan leveren: een echt monster.
1AXI: Mijn kristal is klaar. Ontdekking voltooid!2Onderzoeker: Je hebt een model afgedrukt. Waar ligt het monster?3AXI: Het bakje is nog leeg. Dat is een opvallend lage opbrengst.4Onderzoeker: Onze eerste route gaf een ander materiaal. We bewaren de mislukte proef.5AXI: Nieuwe omstandigheden, nieuwe meting. De voorspelling mag wachten.6Onderzoeker: Nu hebben we bewijs voor deze proef, niet voor iedere mogelijke route.
Model en materiaal
Een gegenereerde structuur is een voorstel. Een proef onderzoekt of een materiaal onder beschreven omstandigheden gemaakt en geïdentificeerd kan worden. Een mislukte synthese kan de kandidaat, gekozen route of meetinterpretatie betreffen. Zij vertelt dus meer wanneer die verschillende mogelijkheden expliciet zijn vastgelegd.
Onze fictieve tafelproef begint eenvoudig: een klein blokje beweegt over een vlak oppervlak. We willen de volgende positie voorspellen, niet meteen de hele natuur beschrijven.
Beschrijf de waarneming
Een camera levert tijdstippen en geschatte posities. Een model krijgt bijvoorbeeld positie en snelheid op tijdstip t en voorspelt de verandering na een vaste tijdstap. Alleen een scherpe foto is niet genoeg: snelheid vraagt meerdere waarnemingen, tijdseenheden en een kalibratie van pixels naar meters. Als de camera verschuift, veranderen de pixelcoördinaten zonder dat het blokje dezelfde fysieke verandering ondergaat. De meetketen hoort daarom bij de modelbeschrijving.
Kies wat mag variëren
Voor het eerste experiment blijven oppervlak, blokvorm en opnamehoek gelijk. We variëren alleen de beginsnelheid. Zo kunnen we één vraag onderzoeken: voorspelt het model nieuwe beginsnelheden binnen het gemeten bereik? Een goede uitkomst bewijst nog niet dat het model een andere ondergrond aankan. Het ontwerp van de proef bepaalt welke generalisatie daadwerkelijk is getoetst. De grens is nuttig: zij voorkomt dat ieder gunstig resultaat onmiddellijk als begrip van wrijving wordt uitgelegd.
Meer dan een tabel met scores
We bewaren trajecten naast gemiddelde fouten. Een model kan na één stap heel nauwkeurig zijn en na twintig herhaalde stappen ver afwijken. Fouten in snelheid veranderen immers latere posities. Een tweede toets kijkt daarom naar volledige voorspelde trajecten, verschillende beginsituaties en een eenvoudige referentiemethode. Een ingewikkeld netwerk verdient pas extra vertrouwen wanneer zijn verbetering zichtbaar is onder dezelfde eerlijke vergelijking.
Het ontwerp van de proef bepaalt welke generalisatie daadwerkelijk is getoetst.
Een model kan dezelfde proef als pixels, punten of een graaf ontvangen. Iedere keuze maakt sommige relaties makkelijker te leren en andere moeilijker te zien.
A
Beeld of toestand
Een netwerk op camerabeelden kan zelf patronen leren, maar moet ook belichting en perspectief verwerken. Een toestandmodel krijgt vooraf geschatte posities en snelheden. Dat maakt de invoer compacter, terwijl fouten van de schatter blijven bestaan. De keuze is dus geen wedstrijd tussen echt zien en vals vereenvoudigen. Zij bepaalt welke onderdelen van de meetketen expliciet zijn en welke binnen een geleerde afbeelding verdwijnen.
B
Een graaf als werktaal
Bij meerdere blokjes maken we knopen voor objecten en verbindingen voor relevante interacties. Een graafnetwerk verwerkt berichten tussen knopen. Daardoor kan een model dezelfde lokale regel op verschillende aantallen objecten toepassen. Dit is een inductieve voorkeur: het ontwerp biedt relaties aan voordat de data alle mogelijkheden hoeven te demonstreren. Het bewijst niet dat de aangeboden verbindingen alle krachten bevatten. Onzichtbare contacten of verkeerde objectdetectie kunnen het model nog steeds op het verkeerde spoor zetten.
C
Wat blijft gelijk na verplaatsen?
Als we de hele tafelcoördinaten verschuiven, behoren relatieve afstanden gelijk te blijven. Een model dat vooral absolute pixelposities gebruikt, kan toch een andere uitkomst geven. Zo’n eenvoudige transformatie levert een gerichte test op. Hetzelfde principe verschijnt in moleculaire modellen: de totale energie hoort niet te veranderen doordat we hetzelfde systeem als geheel draaien. Het modelontwerp kan die eigenschap ondersteunen; de toets blijft nodig om de volledige invoer- en uitvoerroute te controleren.
Een voorspelling kiest een experiment. Een echte waarneming kan vervolgens de representatie, het model of de onderzoeksvraag veranderen. Volg de route en onderscheid wat vooraf verwacht werd van wat werkelijk werd gemeten. AXI is een fictieve observator.
DOSSIERVECTOR • AI IN DE PRAKTIJK
Een voorspelling kiest een proef
Na de eerste trajecten zijn meerdere verklaringen mogelijk. Het volgende experiment kan informatiever zijn dan simpelweg meer van dezelfde gegevens verzamelen.
Waar verschillen modellen?
Ons fictieve team heeft twee modellen die bij lage snelheden bijna dezelfde vertraging voorspellen. Bij hogere snelheden verschillen zij. Een meting in dat gebied kan tussen hun voorspellingen onderscheiden, mits de camera daar betrouwbaar meet. We kiezen niet automatisch het punt met de grootste modelruzie: een onmeetbaar of gevaarlijk punt helpt niet. Kosten, uitvoerbaarheid en de wetenschappelijke vraag begrenzen de kandidaten.
Een aanvraag is een dossier
Voor de nieuwe proef leggen we vooraf beginsituatie, meetduur, eenheden en analyse vast. We bewaren de voorspellingen voordat de nieuwe data worden bekeken. Anders kan het team achteraf een gunstige uitleg selecteren. Een voorspelling met een interval vertelt welke afwijking als onverwacht geldt, maar alleen binnen de betekenis van dat interval. Een modelensemble meet variatie tussen modellen; het omvat niet vanzelf een onbekende fout van de camera.
De lus heeft een echte buitenwereld
De proef levert nieuwe waarnemingen en daarmee nieuwe vragen op. Het blokje kan bijvoorbeeld een onverwachte rotatie krijgen. Dat is geen reden om de data direct weg te gooien als storend. Het kan betekenen dat de toestandbeschrijving een belangrijke variabele mist. We noteren afwijkende gebeurtenissen en maken zichtbaar welke waarnemingen uiteindelijk zijn gebruikt.
AI ondersteunt de onderzoekscyclus wanneer een onverwachte uitkomst het model of de vraag mag veranderen. Een automatisch rapport mag die verrassing niet gladstrijken.
Welke verklaring faalde?
De gemeten vertraging ligt buiten beide voorspellingen. Controleer dan eerst de meetketen: tijdstempels, schaal en mogelijke verandering van het oppervlak. Als de meting overeind blijft, is er bewijs dat de huidige modellen op deze proef onvoldoende waren. Dat is smaller dan het bewijs dat alle graafnetwerken of alle wrijvingswetten onbruikbaar zijn. Een goede conclusie heeft dezelfde reikwijdte als de toets.
Wat moet een extra variabele oplossen?
Misschien mist het model rotatie of temperatuur. Een extra invoer is nuttig wanneer zij nieuwe voorspellende informatie geeft, niet alleen omdat het netwerk daardoor groter wordt. Het team legt de gewijzigde hypothese vast en plant een aparte vergelijking. Een reparatie die exact de verrassende trajecten nadoet is nog geen onafhankelijke bevestiging. De volgende proef vraagt een vooraf gemaakte voorspelling.
Waarom bewaren we negatieve resultaten?
Een archief met alleen succesvolle runs schetst een te eenvoudig verhaal. Bewaar daarom mislukte fits, afgewezen kandidaten en relevante versies. Ze maken zichtbaar hoeveel keuzes nodig waren en kunnen later een alternatieve verklaring ondersteunen. De snelheid van een automatische lus maakt dit belangrijker: veel experimenten leveren ook veel kansen op selectie van toevallig gunstige uitkomsten. Een snelle ontdekking begint bij een navolgbaar spoor.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
TEST JEZELFVECTOR • ONDERZOEK MET AANNAMEN
Quiz: een voorafkans blijft in de som
Vier nieuwe vragen oefenen de expliciete hypotheseminiatuur. Normaliseer pas nadat je gezamenlijke gewichten hebt berekend.
Niveau 3 van 3:★★★ pittig
Gebruik alleen H1 en H2
De likelihoods en de voorafkansen staan op pagina 12–13. Een andere voorafkans kan hetzelfde signaal anders laten wegen. Uitwerkingen staan op pagina 49.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
TEST JEZELFVECTOR • ONDERZOEK MET AANNAMEN
De proef die de twee wetten uit elkaar trekt
Drie eindige modelpuzzels vragen om onderscheidende informatie. Volledige oplossingen staan op pagina 48.
Niveau 3 van 3:★★★ pittig
01
Kandidaat A geeft x(t)=2t; B geeft x(t)=t². Ze passen allebei op een foutloze meting x(2)=4. Je mag daarna t=0 of t=3 meten. Welke tijd onderscheidt ze?
Bekijk het antwoord
t = 3. Bij nul geven beide nul. Bij drie geeft A zes en B negen. Alleen die keuze heeft verschillende voorspellingen onder de foutloze kandidaatwereld.
02
Kies een model x(t)=at+bt². De foutloze punten zijn x(1)=3 en x(2)=8. Welke a,b en voorspelling x(3) volgen uniek?
Bekijk het antwoord
a=2, b=1; x(3)=15. a+b=3 en 2a+4b=8. Trek tweemaal de eerste vergelijking af:2b=2, dus b=1 en a=2. Dan 3a+9b=6+9=15. Twee onafhankelijke vergelijkingen leggen deze twee coëfficiënten vast.
03
Drie toegestane hypotheses voorspellen voor proef X de waarden [1,1,2], en voor proef Y [0,1,2]. Iedere meting is foutloos. Welke ene proef identificeert altijd de juiste hypothese?
Bekijk het antwoord
Y. Y geeft voor iedere hypothese een andere uitkomst:0,1 of 2. X kan de eerste twee niet onderscheiden wanneer 1 verschijnt. De conclusie hangt af van deze drie kandidaten en foutloze meting.
De kandidaatlijst is expliciet
Een unieke oplossing in deze puzzels geldt uitsluitend binnen de gegeven kandidaten of vorm. Andere echte wetten zijn niet stilzwijgend uitgesloten.
Een getal wordt interessant wanneer je weet wat het telt. Deze feiten verbinden AI met meetbare grenzen.
3voorspellen, maken en meten zijn aparte claims
36/40bevestigd bij de gecorrigeerde A-Lab-heranalyse
1.000millimeters per meter
1,2 kWhdidactisch energievoorbeeld
0ideale som van gelijke tegenfasegolven
2verschillende afspraken: invariant en equivariant
Eén nieuwe stof kan meerdere claims vragen
Een kandidaat voorspellen, een monster maken en een eigenschap meten zijn verschillende prestaties. Een fotogeniek kristalmodel bewijst geen succesvolle synthese. Het juiste vervolg hangt van de claim af.
36 is het gecorrigeerde aantal
De A-Lab-auteurscorrectie bevestigt 36 van 40 gerapporteerde successen en noemt 4 onbeslist. Zij verduidelijkt ook nieuw voor het platform tegenover nieuw voor de wetenschap. Lees aantallen altijd met versie en definitie.
Een meter bevat duizend millimeters
Een model dat millimeters als meters ontvangt krijgt een duizendmaal andere schaal. Soms blijft de afbeelding er hetzelfde uitzien terwijl de fysieke interpretatie volledig verandert. Typen en eenheden horen daarom naast de getallen.
Drie uur vertelt meer dan 400 W
Bij gemiddeld 400 W gedurende 3 uur is het verbruik 1,2 kWh. Alleen het vermogen vertelt geen totaal. Training, herhaling en gekozen hardwaregrens kunnen de vergelijking bovendien veranderen.
Twee bronnen kunnen nul optellen
In ons ideale golvenmodel heffen gelijke bijdragen bij faseπ elkaar op. Een detector die alleen de som ziet kan niet zonder meer iedere bron identificeren. Extra experimentinformatie kan belangrijker zijn dan een groter netwerk.
Een symmetrie reduceert een leerprobleem
Draai hetzelfde molecuul: een passende energie verandert niet, een krachtvector draait mee. Dat maakt invariantie en equivariantie verschillende afspraken. Een symmetrisch model kan nog steeds de verkeerde fysieke energie voorspellen.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
DOSSIERVECTOR • ONDERZOEK MET AANNAMEN
Een nieuwe meting verschuift twee hypothesen
Twee fictieve materiaalthypothesen voorspellen verschillende kansen op een positief signaal. Hun onderscheid wordt een concrete Bayesiaanse rekensom.
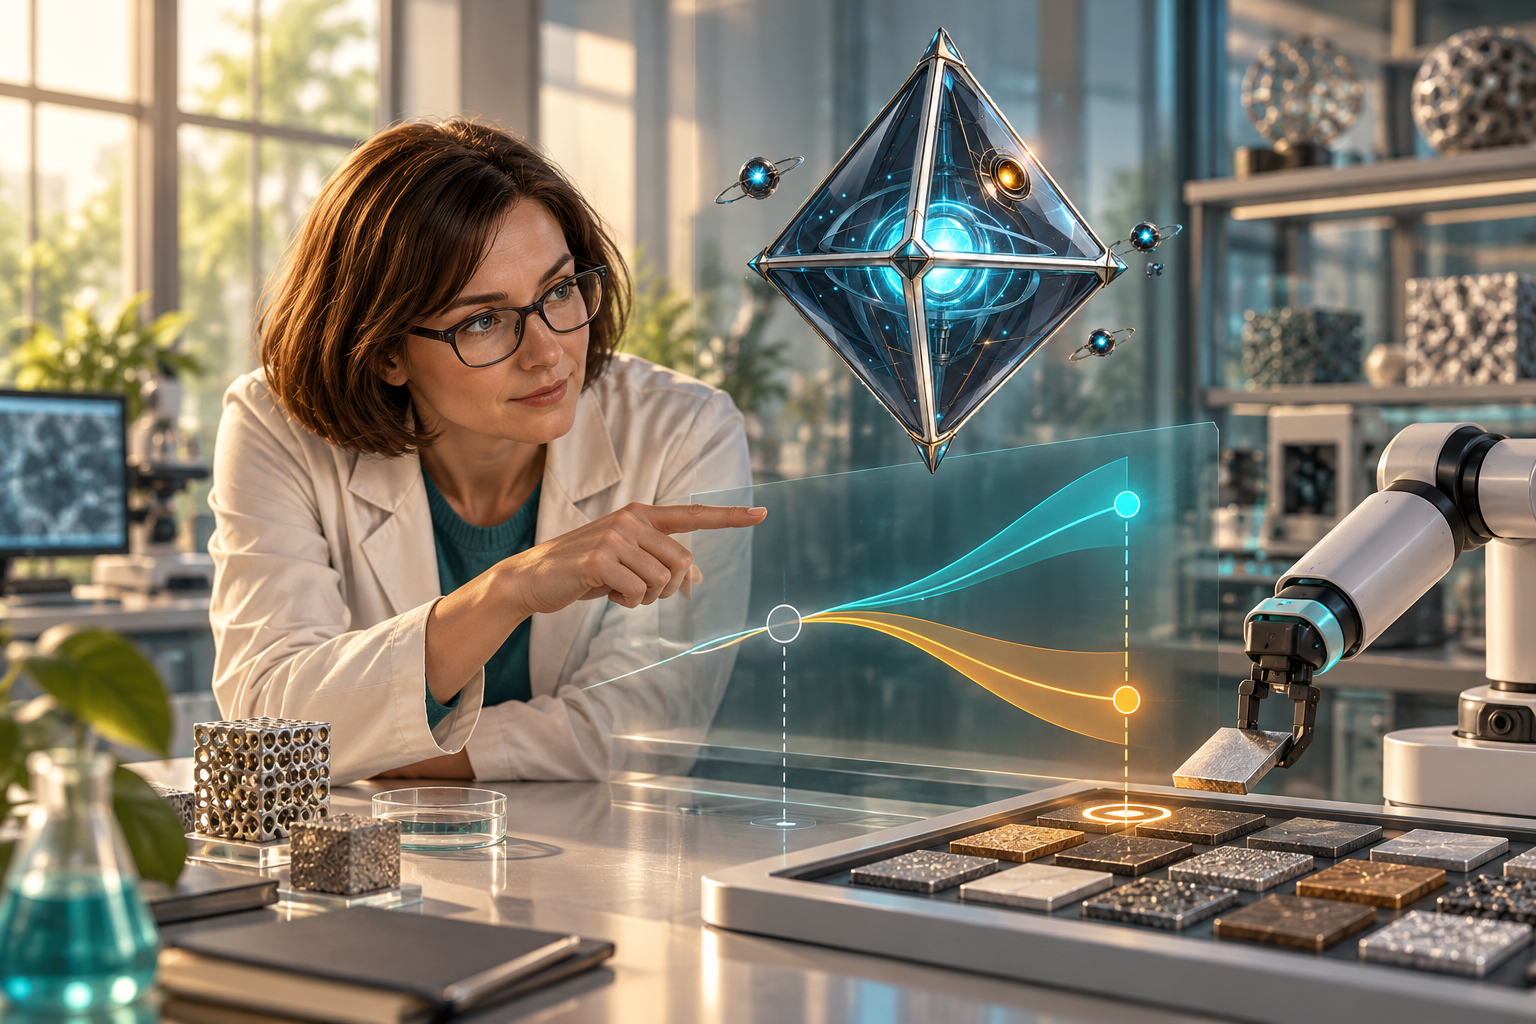
AI-illustratie • een informatieve materiaalproef; de curven tonen mogelijke voorspellingen, geen gemeten gegevens. AXI en de onderzoeker zijn fictief.
01
Twee expliciete mogelijkheden
Stel alleen hypothesen H1 en H2 voor. Vooraf krijgen ze allebei kans 1/2. In proef T is een positief signaal onder H1 waarschijnlijk met kans 0,8 en onder H2 met kans 0,2. Dit zijn aangenomen modelkansen, geen gemeten eigenschappen van een echt materiaal. Een negatief signaal krijgt respectievelijk kans 0,2 en 0,8.
02
Na een positief signaal
Het gezamenlijke gewicht voor H1 én positief is 0,5×0,8 = 0,4. Voor H2 én positief is het 0,5×0,2 = 0,1. De totale positieve kans is 0,5. Normaliseren geeft P(H1|+) = 0,4/0,5 = 0,8. Na een negatief signaal wordt H1 juist 0,2. De meting beslist dus niet foutloos tussen twee wetten; ze verschuift het gewicht van mogelijkheden.
03
Een vraagstrategie krijgt een doel
Active learning onderzoekt hoe een leeralgoritme informatierijke labels of vragen kiest. Bayesian optimization gebruikt een surrogaat en een acquisitiefunctie voor kostbare doelmetingen. Die begrippen raken elkaar, maar onze vraag is specifiek: hoeveel informatie over H1 versus H2 verwacht één proef te leveren? De volgende pagina vergelijkt dat met een goedkoper maar minder onderscheidend alternatief. De optimale keuze verandert wanneer je doel of kosten verandert.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
DOSSIERVECTOR • ONDERZOEK MET AANNAMEN
Informatie per proef is nog geen informatie per euro
Een verwachte informatiewinst kan vooraf worden berekend, ook wanneer je de toekomstige uitkomst nog niet kent.
01
De onzekerheid vóór en na T
Gebruik binaire entropie h(p)=−p log₂p−(1−p)log₂(1−p). Bij p=1/2 is zij 1 bit. Proef T eindigt met posterior 0,8 of 0,2; beide hebben entropie ongeveer 0,7219 bit. De gemiddelde informatiewinst is dus 1−0,7219 ≈ 0,2781 bit. Dat is een verwachting onder onze twee-hypothesenwereld, geen gegarandeerde ontdekking.
02
Een goedkoper alternatief
Proef S heeft aangenomen positieve kansen 0,6 onder H1 en 0,4 onder H2. Met dezelfde voorafkansen zijn de posteriors 0,6 en 0,4. De verwachte winst is 1−h(0,6) ≈ 0,02905 bit. Stel kosten T=2 eenheden en S=1. Dan geeft T ongeveer 0,1390 bit per kosteneenheid, S 0,02905. Binnen dit expliciete doel verdient T de voorkeur.
03
Het doel kan anders luiden
Een fabriek kan de hoogste materiaalopbrengst zoeken in plaats van een hypothese het best onderscheiden. Een meetplaats met grote verwachte opbrengst kan dan interessanter zijn dan de meest onderscheidende plek. Noteer ook meettijd, haalbaarheid en wat je na de uitkomst mag beslissen. Goed gekozen data zijn data voor een gedefinieerd doel; een acquisitiescore zonder dat doel is nog geen onderzoeksplan.
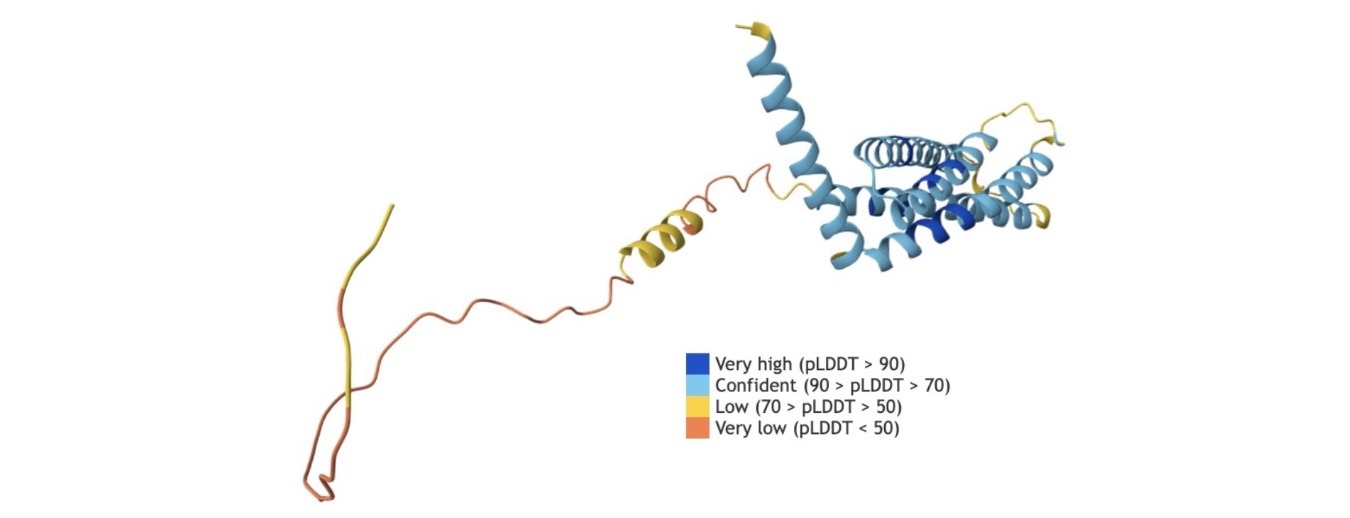
AlphaFold maakte structurele voorspellingen veel krachtiger. De stap van een aminozuurvolgorde naar een ruimtelijk model blijft echter een andere taak dan de volledige werking van een eiwit verklaren.
TMEM253 • een structuurmodel, geen foto van één werkelijk eiwit. Zie beeldcredits voor herkomst.
Structuur is een voorspeltaak
Een eiwitmodel beschrijft waar atomen in een mogelijke structuur liggen. AlphaFold 2 combineert geleerde verwerking met informatie over sequenties en onderlinge relaties. De paper rapporteert sterke resultaten in structurele evaluaties. Zo’n vergelijking vraagt een passende experimentele referentie en een foutmaat. “Nauwkeurig” zonder te vertellen welke atomen, doelen en score zijn bekeken, verliest een belangrijk deel van zijn betekenis.
Vertrouwen verschilt binnen het model
Een voorspelling kan sommige regio’s overtuigend modelleren en andere veel minder goed. Een lokaal vertrouwensgetal helpt die verschillen zien. Het is geen rechtstreekse experimentele waarneming van ieder atoom en geen universele kans dat het gehele eiwit correct is. Sommige flexibele delen hebben geen enkele vaste structuur die alle omstandigheden vangt. Onzekerheid hoort dus niet alleen als voetnoot naast het mooie beeld; zij moet mee in de interpretatie van het resultaat.
Een onderzoeksinstrument
Een hypothese over structuur kan helpen een experiment te ontwerpen, een bestaande meting te interpreteren of een kandidaat voor verdere studie te selecteren. Zij vervangt niet iedere meting van binding, dynamica of functie. Veranderingen in omgeving en interactiepartners kunnen belangrijk zijn. De vruchtbare vraag is daarom concreet: welke volgende waarneming wordt door dit model gerichter, en welke conclusie vereist nog eigen experimenteel bewijs?
STRUCTUUR
De geometrie is een model van atoomposities.
GRENZEN
Eén structuur toont niet alle bewegingen of omstandigheden.
Een computer kan veel mogelijke kristalstructuren rangschikken. Het resultaat wordt wetenschappelijk interessant wanneer de definitie van stabiel en de gebruikte berekening zichtbaar blijven.
3onderscheid voorspelling, synthese en eigenschapsmeting
1duidelijke claim per geplande toets
Een berekende eigenschap
GNoME gebruikt geleerd voorspellen en berekeningen met dichtheidsfunctionaaltheorie om kandidaatmaterialen te onderzoeken. Een kandidaat die volgens dat model gunstig ligt ten opzichte van concurrerende fasen, is niet automatisch een gemaakt poeder in een laboratorium. De berekening beschrijft gekozen fysische aannamen. Temperatuur, reactiesnelheid, verontreiniging en bereikbare syntheseroutes stellen aanvullende vragen. Het woord ontdekking heeft dus meerdere mogelijke betekenissen: een nieuwe berekende kandidaat, een gesynthetiseerd monster of een aangetoonde eigenschap.
Het zoekproces is niet neutraal
Een zoekmodel krijgt eerdere kristallen en gekozen representaties te zien. Daardoor kan het bekende chemische families gemakkelijker behandelen dan slecht vertegenwoordigde gebieden. Een test met willekeurig verdeelde soortgelijke structuren kan minder streng zijn dan een test op geheel nieuwe materiaalfamilies. Bewaar daarom de gegevenssplits en vraag hoe vergelijkbaar een kandidaat is met de trainingsvoorbeelden. Een groot aantal voorstellen vervangt geen begrip van die dekking.
Een kandidaat wordt een onderzoeksvraag
Kies een doel dat toetsbaar is: samenstelling, structuur, stabiliteit onder een beschreven conditie of een meetbare eigenschap. Vervolgens hoort bij die claim een passende referentiemethode. Een model met een lage gemiddelde energiefout kan alsnog de rangorde van twee bijna gelijke kandidaten verkeerd bepalen. Voor een selectie dicht bij een drempel is juist die lokale fout belangrijk. We onderzoeken het besluit, niet alleen de gemiddelde score.
ZO WERKT HET
Van kandidaat naar bewijs
Voorstel: Een model stelt samenstelling en structuur voor.
Berekening: Een gekozen theorie schat relevante eigenschappen.
Monster: Een synthese probeert het materiaal werkelijk te maken.
Meting: Identificatie en eigenschapstoets begrenzen de conclusie.
De stappen beschrijven verschillende claims; geen enkele pijl garandeert succes.
Het A-Lab verbindt materiaalvoorstellen, robots, synthese en analyse. Een latere auteurscorrectie laat zien waarom automatisering ook controleerbare heranalyse nodig heeft.
01
Wat is gecorrigeerd?
De correctie van 19 januari 2026 verduidelijkt dat “nieuw” in de oorspronkelijke claim nieuw voor het voorspellingplatform bedoelde, niet noodzakelijk nieuw voor de wetenschap. De auteurs heranalyseerden diffractiegegevens: 36 van 40 gerapporteerde successen werden bevestigd; 4 bleven onbeslist. Eén ten onrechte meegenomen verbinding werd uit de bespreking verwijderd omdat zij in de trainingsdata zat. We lezen de oorspronkelijke studie dus samen met die correctie.
02
Identificatie is een afzonderlijke taak
Bij poederröntgendiffractie wordt een patroon gebruikt om mogelijke kristalstructuren te onderscheiden. Overlappende fasen en onduidelijke signalen kunnen interpretatie lastig maken. Een automatisch matchalgoritme levert een beoordeling, niet een onfeilbaar etiket. De onderzoekers moeten bepalen wat de gegevens ondersteunen en welke alternatieve verklaringen overblijven. Een duidelijke categorie onbeslist is wetenschappelijk bruikbaarder dan elk monster gedwongen een succesnaam geven.
03
Het leerzame resultaat
De relevante les is geen eenvoudige triomf of ontmaskering van AI. Het systeem automatiseerde een experimentele route, terwijl de sterkere oorspronkelijke interpretatie moest worden begrensd. Een verbeterd archief koppelt doelmateriaal, ruwe meting, analyseversie en oordeel. Daardoor kan iemand later dezelfde claim opnieuw beoordelen. Dat is precies de informatie die in een snel zoekproces makkelijk uit beeld raakt: welk bewijs droeg welk succeslabel?
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
STRIPVECTOR • ONDERZOEK MET AANNAMEN
AXI en de stapel van hetzelfde
Veel meetkaartjes lijken veel kennis, totdat AXI ziet dat zijn robot steeds terugkeert naar dezelfde niet-onderscheidende plek.
1AXI: Honderd kaartjes. Mijn ontdekking groeit!2Onderzoeker: Je meet honderd keer waar beide wetten hetzelfde zeggen.3AXI: Hier gaan hun voorspellingen uit elkaar.4Onderzoeker: Laat de robot dáár een nieuwe meting doen.5AXI: Eén kaart verschuift mijn hypothesekansen.6Onderzoeker: En bewaar het vraagteken voor de volgende proef.
AI-illustratie • Zes fictieve scènes met AXI en een onderzoeker. Dialoog staat onder ieder kader; de beelden leveren geen meetgegevens.
Een herhaling kan nuttig zijn, maar heeft een doel
Herhalingen kunnen ruis helpen beoordelen. In deze fictie wil AXI twee kandidaten onderscheiden die op de oude plek hetzelfde voorspellen. De onderzoeker kiest daarom een plek waar hun voorspellingen verschillen. Ook de nieuwe uitkomst blijft een toets onder aannamen, geen automatische ontdekking.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
GETALLENVECTOR • ONDERZOEK MET AANNAMEN
Zes getallen die nieuwsgierigheid een doel geven
Nieuwe weetjes blijven bij de gegeven miniwerelden. Elk cijfer heeft een eigen teller, model of eenheid.
1 bitgelijke tweekandidatenonzekerheid
4 : 1odds na één positief
16 / 17posterior na twee positieven
9 mgekozen versnellingsterm
10%totale verwachte foutfractie
2verschillende mogelijke doelen
1 • Twee even waarschijnlijke opties
De entropie van [1/2,1/2] is 1 bit. Eén optie die zeker is heeft 0 bit. Dit is een onzekerheidsmaat binnen de gekozen kandidaatverdeling, geen hoeveelheid waarheid in een zin.
2 • Vier op één odds
Na één positieve T-meting uit het dossier zijn de kansen 0,8 en 0,2; hun verhouding is 4. Dat oddsgetal is iets anders dan posterior 1. De tweede hypothese houdt gewicht.
3 • Zestien op één odds
Twee voorwaardelijk onafhankelijke positieve T-metingen vermenigvuldigen de verhouding tweemaal met 4: odds 16, posterior 16/17≈94,12%. Een letterlijke kopie vermenigvuldigt de informatie niet opnieuw.
4 • Eén half meter per seconde kwadraat
Een term 0,5 a t² geeft bij a=2 m/s² en t=3 s een afstand 9 m. Coëfficiënten horen bij een formule en eenheden; het uiterlijk van een getal zegt niet wat het meet.
5 • Tien verwachte fouten
Een fictieve populatie van 80 makkelijke cases met kans 0,05 en 20 moeilijke met kans 0,30 heeft verwachte fouten 4+6=10. De totale verwachte foutfractie is 10%, hoewel geen groep zelf 10% heeft.
6 • Twee verschillende vragen
Eén acquisitiescore kan informatiewinst kiezen, een andere verwachte verbetering van opbrengst. Zelfs met dezelfde surrogaatvoorspellingen kan de volgende proef verschillen. De doelregel is daarom onderdeel van de onderzoeksmethode.
AXI ziet een perfecte digitale greep. De echte proef voegt iets toe dat de simulatie onvoldoende beschreef: het oppervlak.
1AXI: Duizend digitale grepen. Duizend keer raak!2Onderzoeker: En nu het echte blokje. Oei, dat gleed weg.3AXI: De glans was geen versiering. Wat namen we aan over contact?4Onderzoeker: Eerst meten en vergelijken, daarna een gerichte aanpassing.5AXI: Nieuwe proef, dezelfde duidelijke succesvoorwaarde.6Onderzoeker: Laat de echte test naast de simulatie staan.
De kloof is onderzoekbaar
Een simulator benadert relevante eigenschappen. Een verschil met de werkelijkheid kan komen door beeldinterpretatie, contactmodel of materiaal. Onderzoek een gerichte oorzaak voordat je de hele strategie afschrijft. Bewaar de mislukte greep en plan een nieuwe, onafhankelijke toets van de aangepaste hypothese.
Voor een molecuul verandert de totale energie niet doordat je het als geheel draait. Een goed model hoeft diezelfde regel niet voor iedere mogelijke hoek opnieuw uit data te ontdekken.
A
Geometrie als afspraak
Een graaf kan atomen als knopen voorstellen en lokale omgeving via verbindingen verwerken. Wanneer het model symmetrie volgens een voorgeschreven transformatie respecteert, krijgt het een bruikbare structurele beperking. Een energie-uitvoer kan invariant zijn; een voorspelde krachtvector hoort mee te draaien. Dat verschil voorkomt dat het model een willekeurige oriëntatie als eigenschap van het materiaal behandelt.
B
Van energie naar kracht
Bij een geleerd potentiaalmodel kunnen krachten worden afgeleid uit hoe de energie verandert met atoomposities. Dit koppelt twee soorten voorspellingen aan elkaar. Het betekent nog niet dat de geleerde energie overal klopt. Een model dat alleen één reeks configuraties heeft gezien, kan bij andere afstanden onjuiste krachten geven. Langere simulaties brengen dan juist regio’s aan het licht waar het model te weinig steun uit data heeft.
C
Een fysische voorkeur is geen wondermiddel
NequIP onderzoekt zulke equivariantie voor datadoeltreffende interatomaire potentialen. Zijn resultaten horen bij de besproken systemen en datasets. Wij kunnen het algemene ontwerpprincipe overnemen zonder ieder resultaat te veralgemeniseren. Vraag bij een nieuwe toepassing welke symmetrie echt geldig is, welke omgeving ontbreekt en welke onafhankelijke toets nodig is. Een expliciete structuur maakt een fout gemakkelijker te onderzoeken, maar zij verandert voorspellingen niet in rechtstreekse metingen.
KLEINE CONTROLE
Een eenvoudige draaitest
Draai een bestaande configuratie zonder afstanden te wijzigen.
Wat vergelijk je?
Controleer of de energie gelijk blijft binnen de numerieke tolerantie en of de krachtvectoren overeenkomstig meedraaien. Een geslaagde test toont deze symmetrie; hij meet nog geen nauwkeurigheid tegen nieuwe fysieke referentiedata.
Deze simulator modelleert één abstracte afwijking x. Hij toont hoe een eenvoudige update een fout kan verkleinen; hij bestuurt geen robot of laboratorium.
INTERACTIEF MODEL
Abstracte afwijking verkleinen
Speelgoedmodel: L = x² en x′ = x−η·2 x. Geen apparaatbesturing.
Schematisch rekenmodel. De grafiek toont de gekozen aannames, geen gemeten experiment.
Een doel en een update
We kiezen verlies L(x) = x². De gradiënt is 2 x. Een leerstap met grootte η geeft x′ = (1−2 η)x. Begin met x = 3 en η = 0,2. De waarden worden 3; 1,8; 1,08; 0,648: dezelfde richting, steeds dichter bij nul. De verlieswaarde daalt van 9 naar 3,24 en vervolgens 1,1664. De schaal van dit voorbeeld is abstract; een echte regelaar zou meeteenheden, grenzen en vertraging nodig hebben.
Waar wordt de stap te groot?
Bij η = 0,5 komt deze exacte kwadratische update in één stap op nul. Dat is geen algemene optimale stap voor neurale netwerken. Bij η = 0,8 wisselt het teken en krimpt de grootte. Bij η = 1 keert het teken om zonder krimp. Boven 1 groeit de grootte, behalve bij de triviale start op nul. Verander de instellingen en bekijk zowel x als L: een tekenwisseling alleen betekent nog geen mislukking.
Wat vertelt dit over wetenschap?
Optimaliseren maakt een opgegeven doel kleiner. Het bewijst niet dat het doel de relevante fysieke afwijking vangt of dat het geleerde model buiten dit voorbeeld klopt. Juist daarom hebben we in de eerdere artikelen een aparte meetketen en onafhankelijke toets nodig. De simulator is een controleerbare rekenproef waarmee je één onderdeel van een grotere onderzoeksroute kunt begrijpen.
Een tafelrobot koppelt schattingen aan acties en nieuwe waarnemingen. De fysieke lus bevat eigenschappen die een digitale omgeving niet volledig vangt. De illustratie toont een afgebakende onderzoeksopstelling; de artikelen onderzoeken overdracht en bewijs, geen algemene robotvaardigheid.
DOSSIERVECTOR • AI IN DE PRAKTIJK
Een robotactie begint bij een schatting
Een robot ziet geen perfect blokje met een exact middelpunt. Camera’s, sensoren en modellen schatten een toestand die vervolgens een actie ondersteunt.
Van beeld naar grijppunt
Een visiecomponent schat bijvoorbeeld waar een object ligt. Daarna kiest een beleid een positie of beweging. De invoer kan een foto, een korte geschiedenis en een taakbeschrijving bevatten. Vision-language-action onderzoek verbindt zulke soorten informatie met actie-uitvoer. De taak blijft afgebakend: onderzoeksprestaties op gekozen objecten en opdrachten bewijzen geen algemene fysieke vaardigheid in iedere kamer.
Een actie verandert de waarneming
Wanneer de grijper beweegt, verschuift het beeld en verandert het contact. Daarom kan een opvolgende meting belangrijker zijn dan een langere vooraf geschreven actielijst. De controlelus schat de actuele toestand, berekent een toegestane actie en meet opnieuw. Vertraging, sensorruis en onzichtbare contacten beïnvloeden die lus. Een taalmodel dat een plausibel plan formuleert heeft deze regelkring niet automatisch correct uitgevoerd.
Een beperkte speelruimte
Onze illustratie toont een fictieve tafelomgeving met een klein blokje, geen instructie om apparatuur zelfstandig te bedienen. Onderzoekers begrenzen taken, bewegingen en stopvoorwaarden. Een succesvolle greep krijgt een duidelijke definitie: object verplaatst, geen ongewenst contact en resultaat gecontroleerd. Dezelfde taak kan anders uitpakken bij een glad oppervlak of slecht zicht. Daar begint de vervolgtest, niet de conclusie dat het systeem alles begrijpt.
Een simulator maakt veel robotproeven goedkoop beschikbaar. Toch zijn echt licht, contact en materiaal niet identiek aan de variabelen van de digitale omgeving.
Welke eigenschappen varieer je?
Domain randomization varieert bijvoorbeeld belichting, texturen en camerastand in gesimuleerde voorbeelden. Het doel is een beleid minder afhankelijk te maken van één kunstmatige wereld. Voor fysieke overdracht kunnen ook massa, wrijving en sensorvertraging relevant zijn. De juiste variaties volgen uit de taak; lukraak alle waarden verbreden kan nuttige structuur verbergen of een onrealistische leeropgave creëren.
Wat toetst de echte referentieproef?
Een beleid dat alle digitale blokjes grijpt kan falen op een echt glanzend oppervlak. Bewaar daarom afzonderlijke echte testgevallen en beschrijf welke omstandigheden zijn onderzocht. Meet niet alleen het percentage opgetilde objecten, maar ook mislukkingen, noodzakelijke herstarts en eventuele beperkingen. Een verbetering op bekende objecten is iets anders dan overdracht naar nieuwe vormfamilies.
Welke aanname past niet bij de meting?
Een onverwachte mislukking kan tonen welke simulatoraanname te eenvoudig was. Misschien schat de camera een reflectie als rand, of is de veronderstelde wrijving te hoog. Onderzoek eerst een concrete oorzaak en pas daarna het model gericht aan. De volgende test mag opnieuw buiten de gerepareerde simulator liggen. Simulatie is een hulpmiddel voor hypotheses over de wereld; zij is niet de laatste rechter over haar eigen juistheid.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
DOSSIERVECTOR • ONDERZOEK MET AANNAMEN
Een gevonden formule krijgt een dimensiecheck
Symbolische regressie zoekt leesbare verbanden. Een eenvoudige bewegingsformule laat zien wat zo’n verband nog moet doorstaan.
01
De gekozen kandidaatvorm
Voor een fictief bewegingsspoor zoeken we x(t)=at+bt². Als x in meter en t in seconde staat, moet a m/s hebben en b m/s². De foutloze punten x(1)=3 en x(2)=8 geven a=2 en b=1. De voorspelling voor t=3 is 15 m. Dit is een fit binnen een gekozen vorm, geen universele natuurwet.
02
Een formule kan de fit perfect halen
Cranmer en collega’s onderzochten symbolische modellen uit geleerde representaties. Een gevonden uitdrukking blijft afhankelijk van gegevens en gebruikte structuur. Onze kandidaat moet daarom worden getoetst op ongebruikte tijden. Ook dimensies, randvoorwaarden en het bereik van t horen in het verslag. Een mooie formule kan op extrapolatie falen.
KORTE LABNOTITIE
Een derde punt kan de kandidaat breken
Een nieuwe meting hoeft niet in de bestaande fit te worden weggewerkt.
Bewaar de tegenstrijdigheid
Meet je op t=3 een betrouwbare waarde 12 in plaats van 15, controleer eerst meeteenheid en onzekerheid. Daarna kan de gekozen vorm ongeschikt zijn. Bewaar de oorspronkelijke voorspelling voordat je opnieuw fit; juist dat verschil vertelt waar het model tekortschiet.
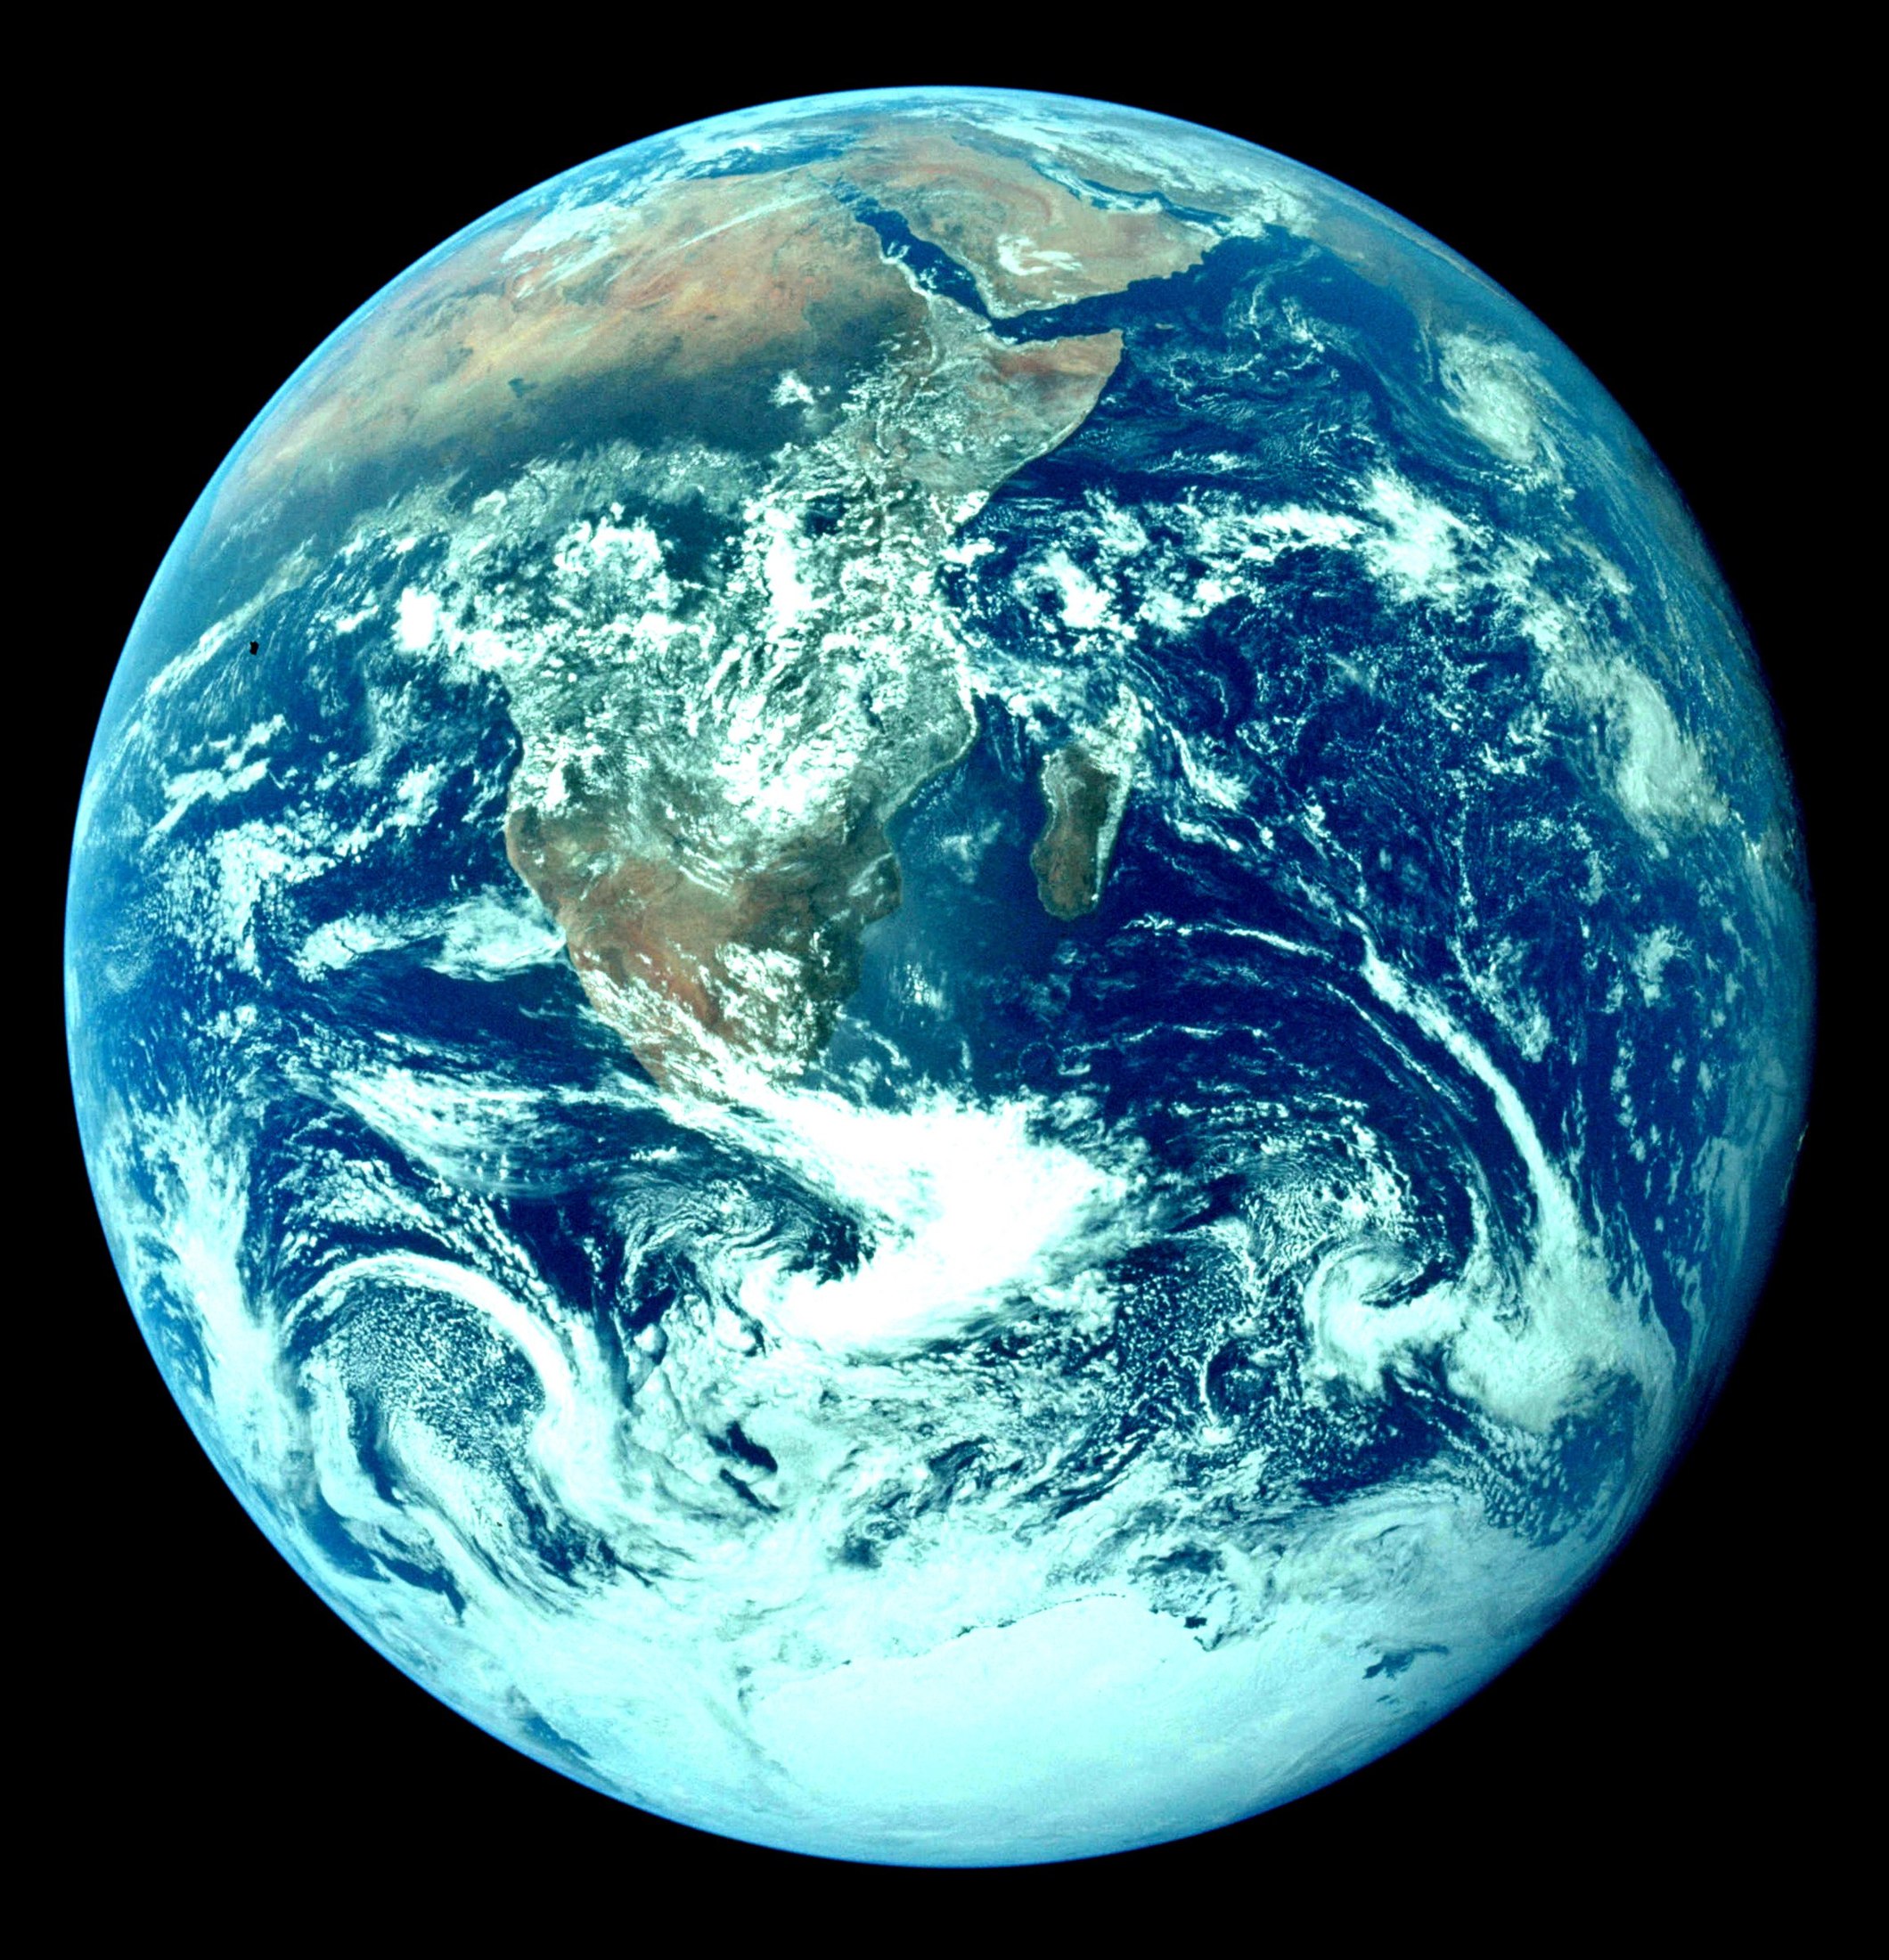
Een weer-AI leert verbanden tussen opeenvolgende toestanden van de atmosfeer. Haar invoer is al een zorgvuldig opgebouwd model van wat er eerder gebeurde.
Apollo 17, Blue Marble • documentaire aardeopname; dit beeld toont geen GraphCast-voorspelling.
01
Heranalyse is samengestelde informatie
ERA 5 combineert waarnemingen met een fysisch model en gegevensassimilatie. Het resultaat is een samenhangende schatting van de atmosfeer, ook waar directe waarnemingen schaars zijn. Wie daarop traint, leert dus niet uit een ruwe film met overal perfect gemeten temperaturen. De kwaliteit en geschiedenis van de invoer tellen mee bij de interpretatie van fouten.
02
Een graaf op de wereldbol
GraphCast gebruikt een geleerd model om atmosferische toestanden vooruit te voorspellen. De studie uit 2023 vergelijkt voorspellingen op beschreven historische evaluaties en variabelen. Zo’n resultaat is krachtig juist omdat het toetsbaar is: welke periode, voorsprong, referentie en foutmaat zijn gebruikt? Een gemiddelde winst bewijst niet dat iedere lokale extreemgebeurtenis beter wordt voorspeld of dat alle toekomstige klimaatcondities binnen de trainingswereld vallen.
03
Een prognose heeft meerdere gebruikers
Een fout in temperatuur op twee meter hoogte en een fout in wind op grote hoogte beantwoorden andere vragen. Ook ruimtelijke resolutie en voorspeltijd veranderen de beoordeling. Vergelijk daarom systemen voor dezelfde taak en passende doelgroep, met uitgesplitste maten. Een ensemble kan scenario’s tonen, maar zijn spreiding is niet automatisch de volledige onzekerheid van de werkelijke atmosfeer. De meetbare winst blijft gekoppeld aan de gekozen evaluatie.
Een sneller wetenschappelijk model kan per berekening goedkoper zijn. Voor een eerlijk energieverhaal moeten we ook training, hardware en het aantal werkelijk uitgevoerde berekeningen tellen.
1,2 kWh400 W maal 3 uur in ons voorbeeld
5 ×totaal bij 50 × zoveel runs tegen 0,1 × energie per run
Watt is niet wattuur
Vermogen beschrijft energie per tijd. Een didactisch rekenvoorbeeld: een taak gebruikt gemiddeld 400 W gedurende 3 uur. Dat is 1.200 Wh, oftewel 1,2 kWh. Als we alleen een piekvermogen noemen, weten we de totale energie nog niet. Gemiddeld vermogen kan bovendien afhankelijk zijn van welke onderdelen zijn gemeten: alleen een accelerator of de gehele computer inclusief geheugen en koeling.
Goedkoper per run kan meer runs opleveren
Stel dat een nieuwe surrogate één voorspelling tienmaal goedkoper maakt en het team vervolgens vijftigmaal zoveel kandidaten onderzoekt. Het totale verbruik voor die voorspelfase kan dan juist groter worden. Dat kan wetenschappelijk de moeite waard zijn, maar het is een andere claim dan energie besparen. We rapporteren daarom aantallen, vaste kosten van training, hergebruik en de prestatie die ervoor terugkomt.
Energie en uitstoot verschillen
Een gemeten kilowattuur heeft eenzelfde energie-eenheid, maar niet overal dezelfde bijbehorende emissies. Locatie, tijd en de gekozen systeemgrens beïnvloeden een uitstootschatting. Henderson en collega’s onderzoeken transparante rapportage voor machine learning. Hun werk ondersteunt onze methode, niet een universeel getal voor ieder model. Een vergelijkende conclusie vraagt dezelfde taak, vergelijkbare kwaliteit en een beschreven meetroute.
ZO WERKT HET
Energie met dezelfde referentie
Oude run: Referentie: energie voor één oude run = 1.
Nieuwe run: Eén nieuwe run kost 0,1 maal de oude.
Nieuw totaal: Vijftig nieuwe runs kosten samen 5 maal de oude run.
Voorbeeldgetallen; geen verbruikstest van een product.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
TEST JEZELFVECTOR • ONDERZOEK MET AANNAMEN
De likelihoodpuzzel
Drie Bayesiaanse rekenwerelden met complete normalisatie. De bewijzen staan op pagina 48.
Niveau 3 van 3:★★★ pittig
01
H1 en H2 zijn vooraf even waarschijnlijk. Twee voorwaardelijk onafhankelijke tests hebben elk P(+|H1)=0,8 en P(+|H2)=0,2. Beide zijn positief. Wat is P(H1|++)?
Bekijk het antwoord
16/17 ≈ 0,9412. Gewichten zijn 0,5×0,8²=0,32 en 0,5×0,2²=0,02. Normaliseren geeft 0,32/0,34=16/17. De volledige uitkomst is niet zekerheid 1.
02
In dezelfde modelwereld zijn drie signalen +,+,−. Wat is de posterior H1?
Bekijk het antwoord
0,8. H1-gewicht is 0,5×0,8×0,8×0,2=0,064. H2-gewicht is 0,5×0,2×0,2×0,8=0,016. 0,064/(0,064+0,016)=0,8. De negatieve meting vermindert de eerdere steun.
03
Bij vooraf gelijke kansen geeft test U P(+|H1)=P(+|H2)=0,7. Er komt een positief signaal. Wat gebeurt met de kansen en waarom?
Bekijk het antwoord
Ze blijven elk 1/2. Beide gewichten krijgen dezelfde factor 0,7:0,35 en 0,35. Normaliseren geeft ieder 1/2. Deze test onderscheidt de twee hypotheses niet, ook al is de positieve uitkomst waarschijnlijk.
Vermenigvuldig onder de gegeven voorwaarden
De signalen zijn onafhankelijk gegeven de hypothese. Dat is een specifieke modelaanname; een gekopieerd signaal voldoet er niet aan.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
WERKPLAATSVECTOR • ONDERZOEK MET AANNAMEN
Ontwerp de volgende informatieve proef
Maak een eigen twee-hypothesenkaart. Je kunt haar oplossen met fictieve waarden en een expliciete kostenafspraak.
Niveau 3 van 3:★★★ pittig
01
Schrijf de mogelijke uitkomsten
Kies twee kandidaten met positieve-testkansen 0,75 en 0,25, vooraf ieder 1/2. Bedenk daarnaast een tweede proef met gelijke kans onder beide kandidaten. Schrijf op wat positief en negatief aan de kansen veranderen. Welke proef kan de kandidaten onderscheiden? Geef kosten in dezelfde eenheid.
02
Maak de kandidaatlijst kwetsbaar
Noteer één waarneming die onder beide kandidaten onwaarschijnlijk is. Wat ga je doen als die verschijnt: het meetproces controleren, een nieuwe kandidaat formuleren of beide? Reserveer ruimte voor de oorspronkelijke voorspelling. Het plan moet leren mogelijk maken, ook wanneer de uitkomst geen bevestiging is.
H1/H2; voorafkansen; likelihoods; mogelijke uitkomsten; kosten; keuzecriterium; waarneming die beide kandidaten kan tegenspreken.
VECTOR +AIEDITIE 05
DENKWERKVECTOR • AI IN DE PRAKTIJK
Drie proeven in je hoofd
AXI stelt drie wetenschappelijke keuzes voor. Houd de aannamen zichtbaar: zonder die begrenzing kunnen meerdere antwoorden redelijk zijn.
GEDACHTENVRAAG 1
De onzekerste kandidaat
Je mag één materiaal meten. Kandidaat A heeft de grootste modelonzekerheid, maar ligt buiten de families die je project nodig heeft. Kandidaat B onderscheidt twee relevante verklaringen.
Moet A toch voorrang krijgen?
Welk besluit verandert de uitkomst?
Wat kosten de twee proeven?
Onderzoek de uitleg
Nee, niet vanzelf. Selectie hangt van het onderzoeksdoel af. Voor onderscheid tussen die verklaringen kan B informatiever zijn. Voor verkenning van onbekende families kan A juist passen. Benoem eerst het doel en vergelijk verwachte informatiewaarde tegen kosten.
Let op de aanname: Verwachte waarde is zelf modelgebonden. Geen strategie garandeert een belangrijke ontdekking.
GEDACHTENVRAAG 2
De stille detector
Twee gelijke bronbijdragen kunnen exact in tegenfase staan. De detector registreert alleen hun som en meet nul.
Bewijst nul dat geen bron actief was?
Welke andere verklaring past?
Welke tweede meting helpt?
Onderzoek de uitleg
Nee. Nul past zowel bij afwezige bronnen als bij opheffing in het ideale model. Meet een bron afzonderlijk of verander gecontroleerd de fase. De extra proef kan de verklaringen onderscheiden omdat zij nieuwe informatie toevoegt.
Let op de aanname: Exacte opheffing veronderstelt passende amplituden en fase; echte sensoren hebben ruis en eindige resolutie.
GEDACHTENVRAAG 3
Het perfect gerepareerde traject
Een model faalt op één nieuw traject. Na afstellen voorspelt het precies dat traject. Het team noemt de fout opgelost.
Welk bewijs ontbreekt?
Is het traject nu ontwikkeldata?
Welke nieuwe conditie kies je?
Onderzoek de uitleg
De reparatie toont fit op het bekende probleem. Zij bewijst geen overdracht. Bewaar het traject als regressietest en toets een vooraf gekozen, onafhankelijke beginsituatie. Controleer ook eerdere prestaties zodat lokaal herstel geen verborgen verslechtering geeft.
Let op de aanname: Een kleine nieuwe proef begrenst een claim, maar schat niet automatisch alle toekomstige foutkansen.
Actief leren kiest welke informatie het model graag wil ontvangen. Wetenschappelijke waarde vraagt daarnaast een verband met de vraag en de kosten van het experiment.
V1Is onzekerheid altijd informatief?
Een model kan onzeker zijn over een zeldzame kandidaat omdat daar weinig data bestaan. Een meting kan waardevol zijn, maar ook nauwelijks invloed hebben op het beoogde besluit. Denk aan een kristal dat moeilijk te maken is en geen onderscheid tussen onze relevante hypotheses oplevert. Alleen de hoogste onzekerheid kiezen is daarom één strategie, geen algemene definitie van goed experimentontwerp.
V2Hoe combineer je zoeken en benutten?
Bayesiaanse optimalisatie gebruikt een surrogaatmodel en een acquisitiefunctie om nieuwe kandidaten te kiezen. Zij kan kans op verbetering afwegen tegen onzekerheid. Zo ontstaan proeven in veelbelovende én onbekende gebieden. De vergelijking hangt af van modellering, kosten en beperkingen. Een procedure die snel een gunstige kandidaat vindt, heeft niet daarmee de gehele ruimte onderzocht of de grootste mogelijke waarde bewezen.
V3Welk doel bepaalt de waarde?
Voor ons blokexperiment kan de volgende meting bedoeld zijn om twee wrijvingsmodellen te onderscheiden. Voor een materiaalproject kan zij bedoeld zijn om een eigenschap te maximaliseren. Dat zijn verschillende doelen. Schrijf daarom vóór selectie op wat een uitkomst aan het besluit verandert. Bewaar ook een kleine onafhankelijke referentieset. Anders kan een actieve zoeklus vooral leren waar zij zelf graag kijkt, terwijl de prestaties daarbuiten onzichtbaar blijven.
Je hoeft geen groot netwerk te bouwen om informatiegerichte selectie te begrijpen. Twee eenvoudige voorspellingen kunnen al laten zien waarom een middenmeting weinig oplevert.
A
Een origineel meetvoorbeeld
Model A voorspelt bij drie mogelijke condities de uitkomsten 10, 15 en 20. Model B voorspelt 10, 15 en 26. Een meting van de eerste of tweede conditie onderscheidt deze modellen niet: hun voorspellingen zijn daar gelijk. De derde conditie heeft een verschil van 6 eenheden. Als de meetonzekerheid veel kleiner is en beide modellen werkelijk deze waarden vooraf vastleggen, kan die proef informatief zijn. Is de onzekerheid groter dan het verschil, dan vraagt de selectie om meer herhalingen of een andere conditie.
B
Eenheden en kosten horen erbij
Een verschil van 6 heeft zonder eenheid geen betekenis. We noemen de uitkomst bijvoorbeeld een verschuiving in millimeter en noteren de resolutie van de meetroute. De goedkoopste proef kan beter zijn wanneer veel herhalingen mogelijk zijn; de duurste proef kan beter zijn wanneer zij een belangrijke alternatieve verklaring uitsluit. We willen geen punten op een grafiek verzameld hebben, maar een vraag beantwoorden. De waarde van een proef is gekoppeld aan dat doel.
C
Wat als beide ongelijk krijgen?
Als de derde meting 17 oplevert met kleine onzekerheid, past zij bij geen van beide vooraf gemaakte voorspellingen. Dan is kiezen tussen A en B een te kleine vraag geweest. Misschien ontbreekt een variabele, een verandering van het proces of een beter model. Het archief met voorspellingen vóór de proef maakt dat zichtbaar. Een nette selectiemethode garandeert geen juiste kandidaten; zij organiseert alleen hoe we tussen gegeven mogelijkheden leren.
DE ACHTERGRONDVRAAG
Waar kwam je onzekerheid vandaan?
Een foutbalk kan verschillende bronnen samenvatten.
Scheid de bronnen
Herhaalde metingen beschrijven variatie in deze proef. Instrumentkalibratie en modelaannamen kunnen andere bijdragen hebben. Een ensemble van voorspellers is niet automatisch een meting van al die bijdragen.
VECTOR +Welke proef verdient de volgende minuut?EDITIE 05
DENKWERKVECTOR • ONDERZOEK MET AANNAMEN
De proef die het doel verkeerd begreep
Een goede vraagstrategie heeft een doel en een toegestane kandidaatwereld nodig. Deze twee gedachtenproeven maken die voorwaarden zichtbaar.
Niveau 3 van 3:★★★ pittig
GEDACHTENVRAAG 1
Informatie of opbrengst
Proef A onderscheidt twee materiaalthypothesen perfect maar test een materiaal met lage opbrengst. Proef B verwacht de hoogste opbrengst maar onderscheidt de hypotheses nauwelijks. Kosten zijn gelijk.
Is er zonder onderzoeksdoel één logisch verplichte winnaar?
Moet je een wet begrijpen of een bruikbaar product vinden?
Wat verandert als beide doelen expliciet worden gewogen?
Onderzoek de uitleg
Nee. Informatiewinst en verwachte opbrengst zijn verschillende doelgrootheden. Kies vooraf een criterium of expliciete afweging. De cijfers maken een keuze beoordeelbaar nadat dat doel is gegeven.
Let op de aanname: In echte onderzoeksprogramma’s kunnen beide doelen samengaan. Het voorbeeld zegt alleen dat hun gewichten niet vanzelf uit de meetkaart volgen.
GEDACHTENVRAAG 2
Een derde wet buiten de lijst
Een algoritme normaliseert kansen uitsluitend over H1 en H2. Het geeft H1 posterior 0,99. In werkelijkheid bestaat ook H3, die niet in het model is opgenomen en andere metingen voorspelt.
Bewijst 0,99 dat H1 in de echte wereld waar is?
Over welke kandidaatlijst is genormaliseerd?
Welke nieuwe voorspelling kan de lijst zelf toetsen?
Onderzoek de uitleg
Nee. De hoge posterior is voorwaardelijk aan de modelwereld en haar likelihoods. Zoek nieuwe metingen die de volledige kandidaatlijst kunnen tegenspreken, niet alleen de twee bestaande namen onderscheiden.
Let op de aanname: Het voorbeeld kent H3 expliciet om de beperking zichtbaar te maken. In de praktijk moet een onderzoeker kandidaatmisspecificatie vermoeden uit domeinkennis en tegenvallende voorspellingen.
Gegevens en fysische structuur hoeven geen concurrenten te zijn. Een model kan waarnemingen verwerken terwijl zijn ontwerp ook een geldige vergelijking of symmetrie ondersteunt.
Een zachte straf heeft gewicht
Een physics-informed neural network kan een verliesbijdrage krijgen voor afwijking van een differentiaalvergelijking. Dat helpt zoeken naar oplossingen die zowel bij data als bij die vergelijking passen. De bijdrage heeft een gewicht naast andere termen. Een klein totaalverlies bewijst niet dat ieder punt exact voldoet of dat de gebruikte vergelijking voor deze omgeving juist is. Randvoorwaarden, numerieke afgeleiden en schaal van de termen beïnvloeden het resultaat.
Een harde afspraak vraagt een geldig model
Een architectuur kan bepaalde eigenschappen exact afdwingen, bijvoorbeeld door een vorm van invariantie in de uitvoer te bouwen. Dat is nuttig wanneer de eigenschap werkelijk geldig is. Een onjuiste hard gecodeerde afspraak maakt correctie juist moeilijker. De natuurkundige onderbouwing moet daarom samen met de modelcode leesbaar blijven. “Fysisch geïnformeerd” beschrijft een ontwerpkeuze, geen algemene kwaliteitsstempel.
Vergelijk eerlijk
Test een hybride model naast een gegevensmodel en een geschikte conventionele methode. Geef ieder dezelfde waarnemingen en vergelijk onder dezelfde taken. Kijk waar de extra structuur helpt en waar zij beperkingen geeft. Sommige experimenten hebben weinig data maar een sterke bekende vergelijking; andere hebben veel waarnemingen en onbekende processen. Het nuttige mengsel hangt van de concrete vraag af.
Bij een geleerde simulator wordt een voorspelde toestand opnieuw invoer voor de volgende stap. Daardoor kan een kleine fout zichzelf veranderen en versterken.
01
Van lokale fout naar traject
Een model dat iedere stap de snelheid iets te hoog schat, krijgt later andere posities te verwerken dan in zijn trainingsdata. Die verschoven invoer kan weer een nieuwe fout veroorzaken. Een gemiddelde éénstapsfout alleen beschrijft dat proces niet. Bewaar daarom rollouts: trajecten die het model meerdere stappen zelfstandig doorrekent. Vergelijk begincondities, looptijd en relevante grootheden zoals positie, contactmomenten of totale energie.
02
Infrastructuur telt mee
De simulator heeft een tijdstap, numerieke precisie en invoerformaat. Een wijziging daarvan kan het resultaat beïnvloeden zonder dat de gewichten veranderen. Ook eenheden zijn belangrijk: millimeters als meters invoeren verandert afstanden duizendmaal. Een reproduceerbaar dossier bevat daarom niet alleen de modelnaam, maar preprocessing, versie, instellingen en de complete procedure van beginconditie naar grafiek.
03
Operatoren voorspellen families
Een neural operator probeert een relatie tussen invoervelden en oplossingsvelden te leren, bijvoorbeeld binnen een familie differentiaalvergelijkingen. Dat is een andere representatie dan één los trajectmemoriseren. De geleerde relatie blijft wel gekoppeld aan het bekeken domein, resoluties en randvoorwaarden. Een gunstige studie-uitkomst motiveert vervolgonderzoek; zij rechtvaardigt niet het gebruik van ieder nieuw fysisch systeem zonder toets. Een andere route zoekt een compacte symbolische relatie in geleerde representaties. Cranmer en collega’s demonstreren dat op beschreven systemen; ook een leesbare formule vraagt daarna een onafhankelijke toets.
De meest overtuigende wetenschappelijke AI-toets onderzoekt juist de situatie waarin een bekende score onvoldoende antwoord geeft.
1AXI: De nieuwe ondergrond lijkt precies dezelfde kleur te hebben.2Onderzoeker: Dat maakt haar wrijving nog niet gelijk.3AXI: Dan testen we de fysieke verandering, niet alleen het plaatje.
Vergelijkingsdossier • peildatum 8 oktober 2026. Een gepubliceerde HLE-score vertelt iets over een concrete evaluatie; een geselecteerde labelset blijft een andere meetvraag.
A
De gepubliceerde resultaten
In Z.ai’s GLM-5.3-modelkaart scoort HLE met tools 62,5 tegenover 54,7 voor GLM-5.2: verschil 7,8 punten. Deze leveranciersresultaten zijn niet door dit magazine gereproduceerd. Een toolsvariant mag je niet rechtstreeks gelijkstellen aan een HLE-run zonder tools.
B
De voetnoot is onderdeel van het getal
Z.ai vermeldt temperatuur 1,0, top-p 0,95, maximaal 163.840 generatietokens, maximaal 300.000 contexttokens met contextbeheer en GPT-5.6 Luna medium als beoordelaar. Het model en de evaluator horen dus allebei in de methode. Gebruik voor eigen wetenschap daarnaast een controleerbare referentie en aparte proeven. De onderstaande fictieve selectieberekening verklaart waarom ook een goede score een beschreven populatie nodig heeft.
C
Aangenomen casus • De complete populatie-afspraak
Neem honderd cases: tachtig makkelijk met foutkans 0,05 en twintig moeilijk met foutkans 0,30. De verwachte foutcount is 80×0,05+20×0,30=10. De verwachte totale foutfractie is 10%. Dit zijn bekende kansen in onze miniwereld; een echt onderzoek moet ze schatten met een geschikte proef.
Een active-learning-route kiest vijf moeilijke cases voor nieuwe labels, omdat die leerzaam kunnen zijn. Hun verwachte foutcount is 5×0,30=1,5 en hun verwachte foutfractie 30%. Dat maakt de route niet slecht: ze heeft bewust een andere selectie. Wel kun je de30% niet zonder meer het foutpercentage van de hele populatie noemen.
D
Twee verzamelingen met twee rollen
Bewaar de gerichte trainingsvragen naast een vooraf gekozen, passende evaluatieset voor de bedoelde populatie. Vermeld selectiebeleid, labelkosten en welke cases opnieuw training zijn geworden. Een verbeterde score op de opgevraagde labels is geen onafhankelijke eindtoets. Nieuwe data krijgen een rol in het onderzoek; “meer labels” beschrijft die rol niet volledig.
Een overtuigende AI-paper moet meer bieden dan een mooie voorspelling. Onderzoek wat iemand anders met dezelfde gegevens en instellingen zou kunnen controleren.
01
Begin bij de claim
Kies één concrete uitspraak uit de samenvatting. Zoek vervolgens de tabel, figuur en methode die haar ondersteunen. Noteer welke doelen, splits en referenties zijn gebruikt. Bij een materialeigenschap kan de referentie zelf een theoretische berekening zijn. Dan is het resultaat bewijs voor overeenkomst met die berekening, niet direct met ieder mogelijk fysiek monster.
02
Zoek het ontbrekende experiment
Welke aannamen werden buiten de test gehouden? Denk aan nieuwe temperaturen, objectvormen, materiaalfamilies of instrumentinstellingen. Een paper hoeft niet alles te testen, maar moet de grens zichtbaar maken. Vraag ook naar fouten en negatieve resultaten. Een geselecteerde demonstratie toont een mogelijkheid; een systematische evaluatie beschrijft onder welke omstandigheden die mogelijkheid terugkomt.
03
Een foutmaat expliciet maken
Voor RMSE kwadrateer je afwijkingen, neem je het gemiddelde en daarna de wortel. De uitkomst heeft dezelfde eenheid als de oorspronkelijke grootheid. Een gemiddelde vervangt geen inspectie van individuele fouten.
Twee bijdragen kunnen samen een patroon vormen waarin hun afzonderlijke aanwezigheid niet direct zichtbaar is. Een leerder die alleen het totaalsignaal krijgt, heeft een inverse probleem.
INTERACTIEF MODEL
Bronnen en totaalsignaal
A·sin(fx)+A·sin(fx+φ), met ideale gelijke amplituden.
golf Agolf Bsom A + B
Schematisch rekenmodel. De grafiek toont de gekozen aannames, geen gemeten experiment.
Wat de simulator optelt
De eerste golf is A·sin(fx), de tweede A·sin(fx+φ). De somcurve is geen nieuw onafhankelijk signaal; zij is de optelling van beide bijdragen. Bij faseverschil nul versterken gelijke golven elkaar. Bij φ = π heffen zij elkaar in dit ideale model op. Een vlak totaalsignaal bewijst dus niet dat er afzonderlijk niets gebeurt. Bekijk de bronbijdragen naast de som om de verschillende verklaringsniveaus te zien.
Van patroon naar verklaring
Een AI-model dat oorzaken uit een meetpatroon schat, heeft aannamen nodig over mogelijke bronnen. Alleen een som meten geeft vaak meerdere verklaringen. Een extra sensor, andere proefconditie of bekende beperking kan informatie toevoegen. Dat is waarom de kwaliteit van een wetenschappelijk systeem niet alleen door netwerkarchitectuur wordt bepaald. Experimentontwerp beslist welke informatie überhaupt in de data kan zitten.
Een eenvoudige grens
Voor gelijke amplitude 1 en frequentie f heeft de som een amplitude 2|cos(φ/2)|. Bij π/2 wordt die √2, niet 1 en niet 2. Onze golven zijn ideale rekenfuncties zonder ruis, tijdvertraging of energieboekhouding. De simulator illustreert identificeerbaarheid en superpositie; hij maakt geen voorspelling van een werkelijk akoestisch of quantumexperiment.
Degrave en collega’s demonstreerden in 2022 magnetische plasmabesturing met deep reinforcement learning op de TCV-tokamak. De prestatie betreft controle, geen bewezen netto energieproductie.
V1Welke taak werd geleerd?
Een tokamak gebruikt magnetische velden om heet plasma te beïnvloeden. De regelaar krijgt informatie over de toestand en kiest besturingssignalen. In reinforcement learning wordt een beleid geleerd op basis van een doel of beloning. De studie koppelt training in simulatie aan toepassing op de onderzoeksinstallatie en onderzoekt verschillende plasmavormen. Het relevante resultaat is dat het beleid de beschreven besturingstaken op het apparaat uitvoerde.
V2Wat is echt op de installatie getoetst?
Het systeem moet rekening houden met dynamica, grenzen en de meetroute. Een gunstige digitale score alleen had de experimentele demonstratie niet vervangen. Ook deze demonstratie blijft afgebakend: installatie, taken en onderzochte condities bepalen de reikwijdte. Wij geven geen bedieningsinstructies; de casus laat zien welke soorten bewijs een fysiek AI-resultaat nodig heeft.
V3Welke grotere claim volgt nog niet?
Besturing is een belangrijk onderdeel van fusieonderzoek, maar zij is niet hetzelfde als een complete energiecentrale. Een robot die één beweging goed leert, bouwt evenmin automatisch een fabriek. De koppeling tussen geleerde actie en echte meting is hier juist de vakinhoudelijke winst. Lees de paper met drie vragen: welke taak werd geleerd, welke controle werd experimenteel uitgevoerd en welke grotere claim volgt daar nog niet uit?
Wetenschappelijke AI groeide niet uit één wondermoment. Nieuwe representaties, toetsroutes en experimentele koppelingen kwamen stap voor stap samen.
01
2007 • Energie wordt geleerd
Behler en Parrinello publiceerden een neurale representatie van hoogdimensionale potentiële-energieoppervlakken. Daarmee krijgt een berekende energie een geleerde benadering. De referentieberekening en dekking van configuraties blijven essentieel.
02
2017 • Moleculen praten als graaf
Neural message passing ordent moleculaire voorspelling rond atomen, verbindingen en geleerde berichten. Het levert een herbruikbare structuur, geen automatische vervanging van chemische referentiemethoden.
03
2020 • Simulatoren en operatoren
Graafsimulatoren en Fourier neural operators tonen verschillende manieren om dynamica of oplossingsfamilies te leren. De taak bepaalt of we objecttrajecten, velden of relaties willen voorspellen.
04
2021–2022 • Structuur en actie
AlphaFold 2 rapporteert sterke structurele voorspellingen. Een jaar later verschijnt geleerde plasmabesturing op TCV. De successen gebruiken heel verschillende meet- en evaluatieroutes.
05
2023–2026 • Kandidaten, proeven en correcties
GNoME en A-Lab verbinden kandidaatselectie met berekening en laboratoriumwerk. De A-Lab-correctie uit 2026 begrenst identificatie en nieuwheidsclaims. Die heranalyse is onderdeel van het onderzoeksverhaal, niet een voetnoot die een tijdlijn mag overslaan.
Gebruik geen echte laboratoriumapparatuur: een tabel of eenvoudige rekenfunctie is genoeg om een reproduceerbare modeltoets te oefenen.
01
Een transparante referentiewereld
Maak een tabel met x = 0,1,2,3,4 en y = 2 x+1. Kies vooraf drie punten voor afstellen en twee voor een afzonderlijke toets. Vergelijk een constante voorspeller met een lijnmodel. Dit is een didactische wereld waarvan de regel bekend is. Zij onderzoekt modelkeuze en gegevensscheiding, niet de juistheid van een natuurwet.
02
Verander één conditie
Maak vervolgens een tweede wereld y = 2 x+1+0,2 x². Pas de eerdere modellen eerst zonder nieuwe afstelling toe. Bewaar de fouten per punt. Daarna kun je een nieuwe hypothese met een krommingsterm onderzoeken. Het verschil tussen onafhankelijke toets en reparatie wordt zichtbaar als je de oorspronkelijke voorspellingen niet overschrijft. Eindig met één beperkte conclusie en de volgende vraag die je zou testen.
Lees een paper vanuit haar toetsroute. Zoek hoe een resultaat is gedefinieerd voordat je zijn grootste getal overneemt.
01
AlphaFold 2 • wat is de referentie?
Zoek welke structuurdoelen worden vergeleken en hoe lokale zekerheid wordt weergegeven. Noteer één conclusie over geometrie en één vraag over dynamica die buiten die evaluatie valt. Een structuurplaat is bruikbaar wanneer zijn grenzen meegelezen worden.
02
NequIP • welke symmetrie?
Bekijk hoe de architectuur energie en krachten verwerkt. Zoek welke systemen de auteurs testen. Maak onderscheid tussen een exacte ontwerpeigenschap en een empirisch gemeten voorspellingsfout.
03
GraphCast • welke atmosfeer?
Controleer gebruikte gegevens, voorspeltijden en evaluatievariabelen. Een historische vergelijking maakt een claim navolgbaar. Zij is geen voorspelling dat elk toekomstig extreem beter wordt behandeld.
04
TCV • welke actie was echt?
Lees waar de training plaatsvond en wat op de installatie werd gedemonstreerd. Schrijf de besturingsprestatie zonder er netto energieproductie aan toe te voegen.
05
A-Lab • welke publicatieversie?
Lees de oorspronkelijke studie met de correctie uit 2026. Vergelijk de definities van succes en nieuwheid. Dat is een praktische oefening in wetenschappelijke broncontrole.
06
Actief leren • wat is het doel?
Settles beschrijft verschillende querystrategieën en omstandigheden. Zoek hoe onzekerheid, kosten en labelkwaliteit de keuze beïnvloeden. Zet vervolgens één strategie naast de concrete vraag uit jouw eigen proef.
Controleer niet alleen de uitkomst, maar ook welk object de score of eenheid beschrijft.
Quiz • pagina 10
1B. Een berekende kandidaat is geen gemaakte en geïdentificeerde stof. Zie pagina’s 15–16. 2A. Een inductieve structuur ondersteunt leren; juiste relaties en onafhankelijke data blijven nodig. Zie pagina 5. 3C. Structuurvertrouwen is geen complete dynamische of functionele beschrijving. Zie pagina 14. 4B. De simulatie bevat aannamen; de fysieke test onderzoekt hun betekenis voor de taak. Zie pagina’s 22–23. 5A. Onzekerheid alleen is geen complete experimentele waarde. Zie pagina’s 32–33. 6C. De experimentele claim betreft controle; netto energieproductie volgt er niet uit. Zie pagina 43.
Quiz • pagina 26
1B. Heranalyse schat een samenhangende eerdere atmosfeer; zij is geen ruwe meetfilm. Zie pagina 27. 2C. Herhaalde voorspellingen veranderen de latere invoer en kunnen fouten vergroten. Zie pagina 38. 3A. Energie is hier een invariant scalair; een krachtvector is equivariant. Zie pagina 20. 4B. Hetzelfde totaalsignaal kan meerdere bronverklaringen hebben. Zie pagina 42. 5C. Een zachte straf is geen universele exacte constraint; de aanname moet geldig zijn. Zie pagina 37. 6A. Energie, aantallen runs en meetgrenzen bepalen de vergelijking. Zie pagina 28.
Quiz • pagina 36
1B. 400 W × 3 uur = 1.200 Wh = 1,2 kWh. Vermogen maal tijd geeft energie. Zie pagina 28. 2C. De gemiddelde gekwadrateerde fout is (1+4+4)/3 = 3 mm². Neem daarvan de wortel. Zie pagina 41. 3A. x′ = 3−0,2 × 2 × 3 = 1,8. Het nieuwe verlies is 3,24 in plaats van 9. Zie pagina 21. 4B. 2|cos(π/4)| = √2. Het resultaat volgt uit gelijke amplitude en gelijke frequentie. Zie pagina 42.
Gedachtenproeven • pagina 31
1. De onzekerste kandidaat: Nee, niet vanzelf. Selectie hangt van het onderzoeksdoel af. Voor onderscheid tussen die verklaringen kan B informatiever zijn. Voor verkenning van onbekende families kan A juist passen. Benoem eerst het doel en vergelijk verwachte informatiewaarde tegen kosten. Grens: Verwachte waarde is zelf modelgebonden. Geen strategie garandeert een belangrijke ontdekking. 2. De stille detector: Nee. Nul past zowel bij afwezige bronnen als bij opheffing in het ideale model. Meet een bron afzonderlijk of verander gecontroleerd de fase. De extra proef kan de verklaringen onderscheiden omdat zij nieuwe informatie toevoegt. Grens: Exacte opheffing veronderstelt passende amplituden en fase; echte sensoren hebben ruis en eindige resolutie. 3. Het perfect gerepareerde traject: De reparatie toont fit op het bekende probleem. Zij bewijst geen overdracht. Bewaar het traject als regressietest en toets een vooraf gekozen, onafhankelijke beginsituatie. Controleer ook eerdere prestaties zodat lokaal herstel geen verborgen verslechtering geeft. Grens: Een kleine nieuwe proef begrenst een claim, maar schat niet automatisch alle toekomstige foutkansen.
Simulator • pagina 21
Bij L = x² is x′ = (1−2 η)x. Start 3 met η = 0,2 geeft 3; 1,8; 1,08; 0,648. Bij η = 0,5 volgt nul in één stap. Voor 0<η<1 krimpt de grootte; bij 1 blijft zij gelijk; boven 1 groeit zij behalve bij startnul. Die grens hoort uitsluitend bij dit exacte speelgoedverlies.
Simulator • pagina 42
De somamplitude is 2A|cos(φ/2)|. Bij φ = 0 is zij 2A, bij π/2 is zij A√2 en bij π is zij 0. Een nulsom identificeert geen afzonderlijke afwezige bron. De formule veronderstelt gelijke amplitude en frequentie.
Notitieboek • pagina 45
Voor de eerste regel zijn y-waarden 1; 3; 5; 7; 9. De tweede wereld geeft 1; 3,2; 5,8; 8,8; 12,2. Het oorspronkelijke lijnmodel heeft daar fouten 0; −0,2; −0,8; −1,8; −3,2: dit zijn modeluitvoer min referentie. Nieuwe afstelling is een nieuw experiment.
De voorbeelden zijn aangenomen miniwerelden. Iedere oplossing gebruikt precies de aangegeven voorwaarden.
Raadsels • pagina 9
1. t = 3. Bij nul geven beide nul. Bij drie geeft A zes en B negen. Alleen die keuze heeft verschillende voorspellingen onder de foutloze kandidaatwereld.
2. a=2, b=1; x(3)=15. a+b=3 en 2a+4b=8. Trek tweemaal de eerste vergelijking af:2b=2, dus b=1 en a=2. Dan 3a+9b=6+9=15. Twee onafhankelijke vergelijkingen leggen deze twee coëfficiënten vast.
3. Y. Y geeft voor iedere hypothese een andere uitkomst:0,1 of 2. X kan de eerste twee niet onderscheiden wanneer 1 verschijnt. De conclusie hangt af van deze drie kandidaten en foutloze meting.
Raadsels • pagina 29
1. 16/17 ≈ 0,9412. Gewichten zijn 0,5×0,8²=0,32 en 0,5×0,2²=0,02. Normaliseren geeft 0,32/0,34=16/17. De volledige uitkomst is niet zekerheid 1.
2. 0,8. H1-gewicht is 0,5×0,8×0,8×0,2=0,064. H2-gewicht is 0,5×0,2×0,2×0,8=0,016. 0,064/(0,064+0,016)=0,8. De negatieve meting vermindert de eerdere steun.
3. Ze blijven elk 1/2. Beide gewichten krijgen dezelfde factor 0,7:0,35 en 0,35. Normaliseren geeft ieder 1/2. Deze test onderscheidt de twee hypotheses niet, ook al is de positieve uitkomst waarschijnlijk.
Gedachtenproeven • pagina 35
Informatie of opbrengst: Nee. Informatiewinst en verwachte opbrengst zijn verschillende doelgrootheden. Kies vooraf een criterium of expliciete afweging. De cijfers maken een keuze beoordeelbaar nadat dat doel is gegeven. In echte onderzoeksprogramma’s kunnen beide doelen samengaan. Het voorbeeld zegt alleen dat hun gewichten niet vanzelf uit de meetkaart volgen.
Een derde wet buiten de lijst: Nee. De hoge posterior is voorwaardelijk aan de modelwereld en haar likelihoods. Zoek nieuwe metingen die de volledige kandidaatlijst kunnen tegenspreken, niet alleen de twee bestaande namen onderscheiden. Het voorbeeld kent H3 expliciet om de beperking zichtbaar te maken. In de praktijk moet een onderzoeker kandidaatmisspecificatie vermoeden uit domeinkennis en tegenvallende voorspellingen.
De voorbeelden zijn aangenomen miniwerelden. Iedere oplossing gebruikt precies de aangegeven voorwaarden.
Quiz • pagina 8
1. B. (0,5×0,8)/(0,5×0,8+0,5×0,2)=0,4/0,5=0,8. Zie pagina 12.
2. A. Negatief heeft kans 0,2 onder H1 en 0,8 onder H2; normaliseren geeft 0,2. Zie pagina 12.
3. C. Gewichten zijn 0,25×0,8=0,20 en 0,75×0,2=0,15. 0,20/0,35=4/7. Zie pagina 12.
4. B. Voor nieuwe likelihoodfactoren is de passende onafhankelijkheidsafspraak nodig; een kopie voldoet niet. Zie pagina 35.
Quiz • pagina 24
1. C. 0,2781/2=0,13905 bit per eenheid. Zie pagina 13.
2. A. 0,13905>0,02905. Dit doel zegt niet welk experiment de hoogste materiaalopbrengst geeft. Zie pagina 13.
3. B. Beide termen moeten meter zijn: (m/s)×s en (m/s²)×s². Zie pagina 25.
4. C. 2×3+1×3²=6+9=15 m. Zie pagina 25.
Quiz • pagina 34
1. B. 80×0,05+20×0,30=4+6=10. Zie pagina 40.
2. A. 10/100=10%. De moeilijke groep apart heeft 30%, niet de hele populatie. Zie pagina 40.
3. C. De gerichte leerselection oversampling van moeilijk kan nuttig zijn, maar schat niet rechtstreeks de totale mix. Zie pagina 40.
4. B. Nieuwe punten kunnen voorspellingen buiten de fit tegenspreken. Zie pagina 25.
AI helpt vragen stellen en gegevens verwerken. Een zorgvuldig beschreven toets bepaalt wat een antwoord waard is.
Over deze editie
VECTOR bevat oorspronkelijke uitleg, didactische rekenwerelden en primaire bronnen. AXI en beide strips zijn fictie; AXI wordt niet als bewust systeem opgevoerd. Documentaire foto’s en wetenschappelijke modelbeelden hebben eigen credits. Illustraties zijn als zodanig gemarkeerd. De A-Lab-casus gebruikt de auteurscorrectie uit 2026. Onderzoeksresultaten blijven gekoppeld aan taken, gegevens en omstandigheden. Bewaar bij hergebruik de bronverwijzingen, beeldcredits en licenties.
Correctie 19 januari 2026: 36 bevestigde van 40 gerapporteerde successen; 4 onbeslist; nieuw voor het platform is niet noodzakelijk nieuw voor de wetenschap.
Geraadpleegd 8 oktober 2026: IndexShare, 1M-context en architectuur; eigen afleiding van laagdeling is geen gemeten systeemsnelheid.
Beeld & diagrammen
AXI, de strip en de als illustratie vermelde scènes zijn originele, met AI gemaakte beelden. De foto's hieronder zijn echte foto's. Diagrammen en simulaties zijn schematische uitlegmodellen.
The Blue Marble.jpg · NASA / Apollo 17-bemanning; kleurcorrectie door Deglr6328 · Publiek domein. Verkleind en JPEG-compressie voor webgebruik; mogelijk bijgesneden in de pagina-opmaak.
TMEM253 AlphaFold Predicted Structure.jpg · Liu02511 · CC0. Computerweergave van een AlphaFold-voorspelling (geen foto), gekleurd naar pLDDT. Op een breder wit vlak geplaatst (1350 × 518 px) zodat de opmaak niets van de structuur afsnijdt; opnieuw als JPEG opgeslagen.
Originele illustraties
AXI, de waarnemer · Originele AI-illustratie voor VECTOR. Fictieve gefacetteerde onderzoeksmascotte, gemaakt met ImageGen.
VECTOR 05 — conceptillustratie voor dubbele pagina · Originele AI-illustratie voor VECTOR. Gemaakt met de ingebouwde ImageGen-tool en vaste personagereferenties. Fictieve illustratie, geen foto of gemeten experiment. Prompt: Content/illustration-prompts/issues-02-05.json.
VECTOR 05 — conceptillustratie voor dubbele pagina · Originele AI-illustratie voor VECTOR. Gemaakt met de ingebouwde ImageGen-tool en vaste personagereferenties. Fictieve illustratie, geen foto of gemeten experiment. Prompt: Content/illustration-prompts/issues-02-05.json.
VECTOR 05 — zesdelige strip · Originele AI-illustratie voor VECTOR. Gemaakt met de ingebouwde ImageGen-tool en vaste personagereferenties. Zes scènes; de dialogen worden afzonderlijk gezet. Fictieve illustratie, geen foto of gemeten experiment. Prompt: Content/illustration-prompts/issues-02-05.json.
VECTOR 05 — zesdelige strip · Originele AI-illustratie voor VECTOR. Gemaakt met de ingebouwde ImageGen-tool en vaste personagereferenties. Zes scènes; de dialogen worden afzonderlijk gezet. Fictieve illustratie, geen foto of gemeten experiment. Prompt: Content/illustration-prompts/issues-02-05.json.
Vector 05 cover new · Originele AI-illustratie voor VECTOR. Oorspronkelijke illustratie gemaakt met de ingebouwde ImageGen. Geen echte foto, onderzoekswaarneming of meetbewijs.
Vector 05 bayes lab · Originele AI-illustratie voor VECTOR. Oorspronkelijke illustratie gemaakt met de ingebouwde ImageGen. Geen echte foto, onderzoekswaarneming of meetbewijs.
Vector 05 axi comic 3 · Originele AI-illustratie voor VECTOR. Oorspronkelijke illustratie gemaakt met de ingebouwde ImageGen. Geen echte foto, onderzoekswaarneming of meetbewijs.